Hindsight 中文教程:给你的 AI 助手装上会学习的长期记忆
2026-11-04发表于
人工智能一、速览:Hindsight 是什么,能帮你解决什么痛点
入门
很多 AI 助手都有一个共同毛病:每次对话都是“失忆”状态。你刚告诉它“我喜欢喝冰美式”,关掉窗口再回来,它就什么都不记得了。市面上一些记忆方案只是把聊天记录存下来,下次原样翻出来,但 Hindsight 不一样。
Hindsight 是一个开源的智能体记忆系统(Agent Memory System)。它的目标不是“记住”,而是让 AI 从历史信息里学习。它会把你说过的重要事实自动提取出来,整理成结构化的记忆,并在后续对话中主动调用这些记忆,让你的 AI 助手越用越懂你。
可以把 Hindsight 想象成一个会定期整理和更新笔记本的秘书,而不是一个只会翻旧账的档案管理员。它适合所有想给自建 AI 应用(聊天机器人、客服、个人助理等)添加长期记忆能力的开发者。
二、快速部署:从零开始接入 Hindsight
入门
Hindsight 提供了两种使用方式:官方云服务(Hindsight Cloud)和自托管(Self-hosted)。对新手来说,先用云服务验证效果最省事,不需要碰服务器。
前置条件:你需要一台能联网的电脑,安装 Python 3.10 以上版本(Python 是一门编程语言,很多 AI 工具都用它运行),以及一个已注册的大模型 API key(比如 OpenAI 或 Anthropic 的密钥,相当于调用 AI 模型的“通行证”)。
如果你选择自托管,先安装 Python 包管理器 pip(通常装 Python 时会自动带上),然后执行:
pip install hindsight-api hindsight-client
hindsight-api 是服务端,hindsight-client 是给代码里调用的客户端。装完后需要配置环境变量(下一节会讲),再按官方文档启动 API 服务。服务启动后,客户端 SDK 就能连上它读写记忆了。
如果只是先试用,建议直接用 Hindsight Cloud,把后面配置中的服务地址填成官方提供的地址,跳过本地部署环节。
三、配置详解:环境变量、存储和模型提供商
进阶 · 推荐细读
环境变量(Environment Variables)是操作系统里的一些“全局设置开关”,程序启动时会读取它们来决定行为。Hindsight 的核心配置就靠这些变量。
最关键的变量是 HINDSIGHT_API_LLM_PROVIDER,它决定 Hindsight 用哪个大模型来“消化”和整理记忆。这个变量支持非常多选项,覆盖了主流平台:
- 云端模型:
openai、anthropic、gemini、groq、bedrock、deepseek等 - 本地模型:
ollama、lmstudio、llamacpp(适合不想把数据传上云的用户) - 已有订阅:
openai-codex(ChatGPT Plus/Pro)、claude-code(Claude Pro/Max)、cursor、github-copilot,这些甚至不需要单独申请 API key
设置方式是在终端里执行类似下面的命令:
export HINDSIGHT_API_LLM_PROVIDER=openai
export OPENAI_API_KEY=你的密钥
存储方面,Hindsight 支持多种数据库后端,官方提到与 Oracle 23ai 完全对等,也支持其他常见存储。具体存储连接串需要参考官方配置文档,新人可以先使用默认的本地存储,之后数据量大了再迁移。
四、功能导览:如何给 agent 添加会学习的记忆
进阶 · 推荐细读
接入 Hindsight 最偷懒的方式是用它提供的 wrap 函数。wrap_openai() 可以把你原本使用的 OpenAI 客户端“包裹”一层,让它自动拥有记忆能力。
典型调用长这样:
from hindsight_client import wrap_openai
from openai import OpenAI

client = wrap_openai(OpenAI())

response = client.chat.completions.create(
    model="gpt-4o",
    messages=[{"role": "user", "content": "Hello, what do you know about me?"}],
)
wrap_anthropic() 对 Anthropic SDK 做同样的事。这个包裹层由 LiteLLM 支撑,所以同一个集成能覆盖 100 多个模型。
如果你不想让记忆“全自动”发生,需要精确控制什么时候存、什么时候取,可以直接使用 Hindsight 的 SDK 或 REST API。REST API 是一种通过网页请求来控制服务的方式,可以用任何编程语言调用。
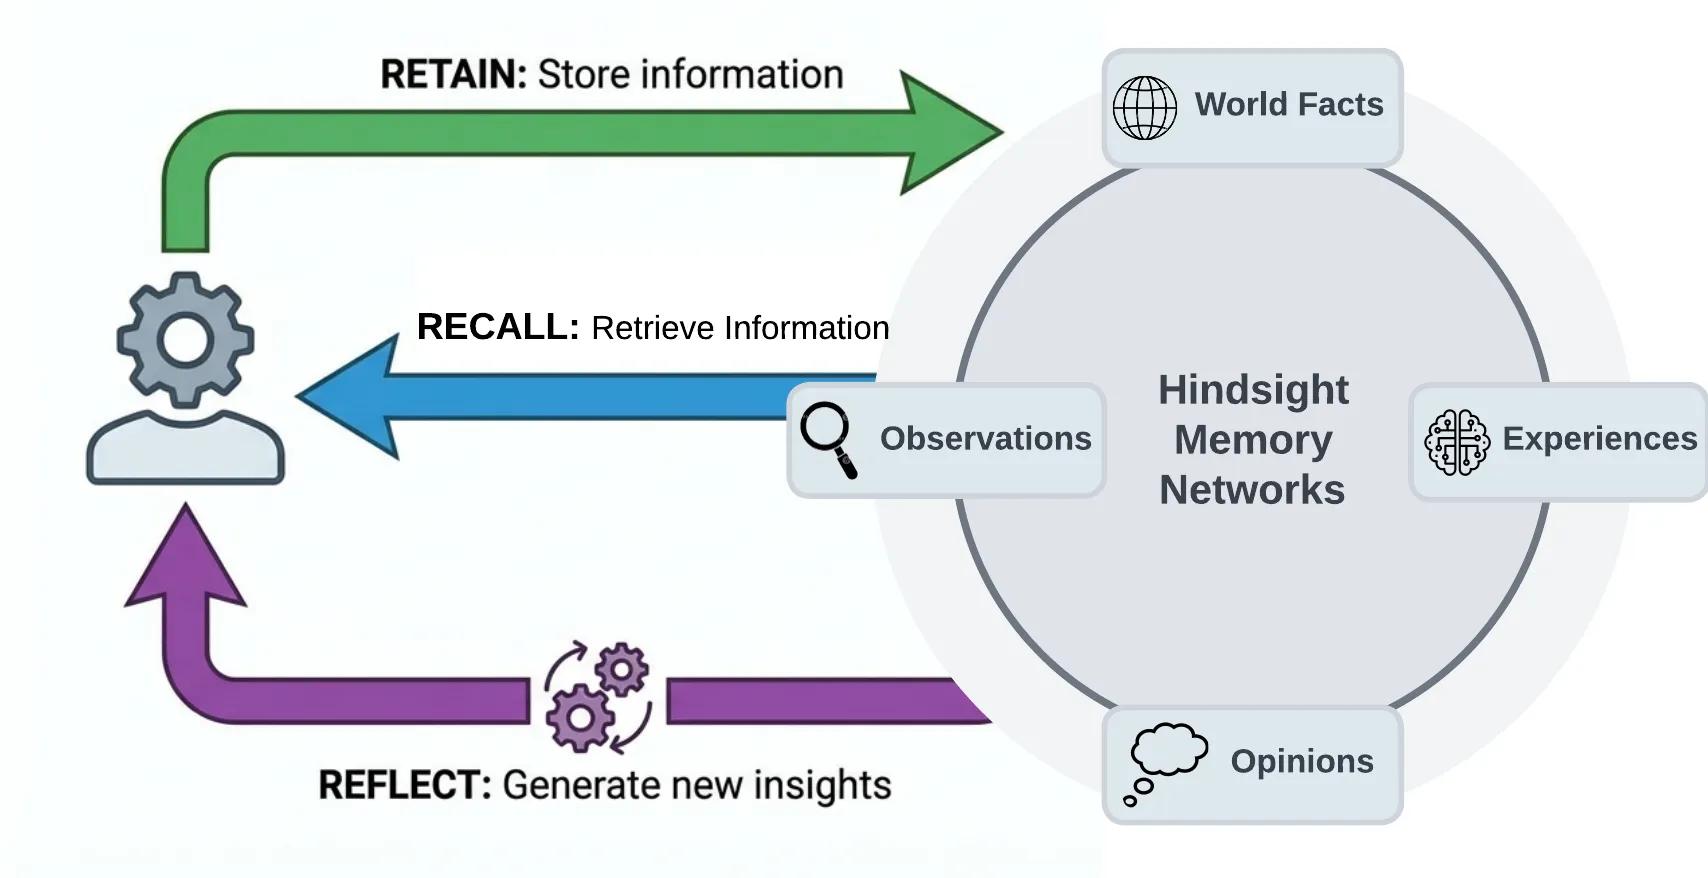
Hindsight 有两个核心概念要理解:
- Memory Bank(记忆库):类似一个文件夹,用来存放特定主题或特定用户的记忆,不同 bank 之间互不干扰。
- Recall(回忆)与 Reflect(反思):Recall 是“现在需要什么就取什么”;Reflect 是“定期回头看,把零散信息总结成更高级的知识”。Hindsight 的创新就在于强调 Reflect,让 AI 真正从信息中学习。
五、常见问题
入门
新手接入时最常遇到几个坑,提前说明一下:
模型 API key 配置错误:如果你选 openai 作为 provider,却没有设置 OPENAI_API_KEY,服务会启动失败。建议先单独测试一下 key 能否正常调用模型。
记忆不生效:wrap 之后还是“失忆”,多半是服务地址没配对,客户端连不上 API 服务。确认你用的是云服务地址还是本地地址,以及对应端口是否开放。
数据持久化:自托管时,如果数据存放在容器或临时目录里,重启服务可能丢数据。建议把存储路径挂载到宿主机固定目录,类似“把文件放在家里而不是快递柜里”。
注意:如果你用本地模型(如 ollama),需要先启动本地模型服务,并确保 Hindsight 能访问到那个地址,否则会报网络连接错误。
六、运维进阶:反向代理、监控与升级
深入 · 老手可选
当 Hindsight 作为正式服务对外提供时,你可能会需要以下操作:
反向代理与 HTTPS:可以用 Nginx 或 Caddy 把 Hindsight 的 API 接口暴露到公网,并加上 HTTPS 证书。反向代理就是“门卫替你把请求转给内部服务”,同时能加一层安全保护。
监控:Hindsight 内置了 Prometheus 指标输出,能监控大模型调用次数、token 消耗和响应延迟。Prometheus 是一款开源的监控系统,可以配合 Grafana 做可视化看板。
升级策略:升级前先备份你的配置文件和存储数据,建议在测试环境跑一遍新版本再切换生产。Hindsight 提供了 admin CLI 工具,用于数据库迁移和修复卡住的操作,升级后如果遇到异常可以先跑一下相关命令。
数据备份:无论用什么存储后端,定期导出备份是好习惯。把备份文件放在不同的物理位置,能避免服务器故障导致记忆全部丢失。
项目信息
| 项目 | 值 |
|---|---|
| 仓库 | vectorize-io/hindsight |
| 语言 | Python |
| Star | 58,078 |
| Fork | 7,131 |
| 主页 | https://hindsight.vectorize.io/ |
参考链接
延伸阅读
想继续探索?这些同领域的教程可能也适合你:

179
73
1
4969
文章目录
评论